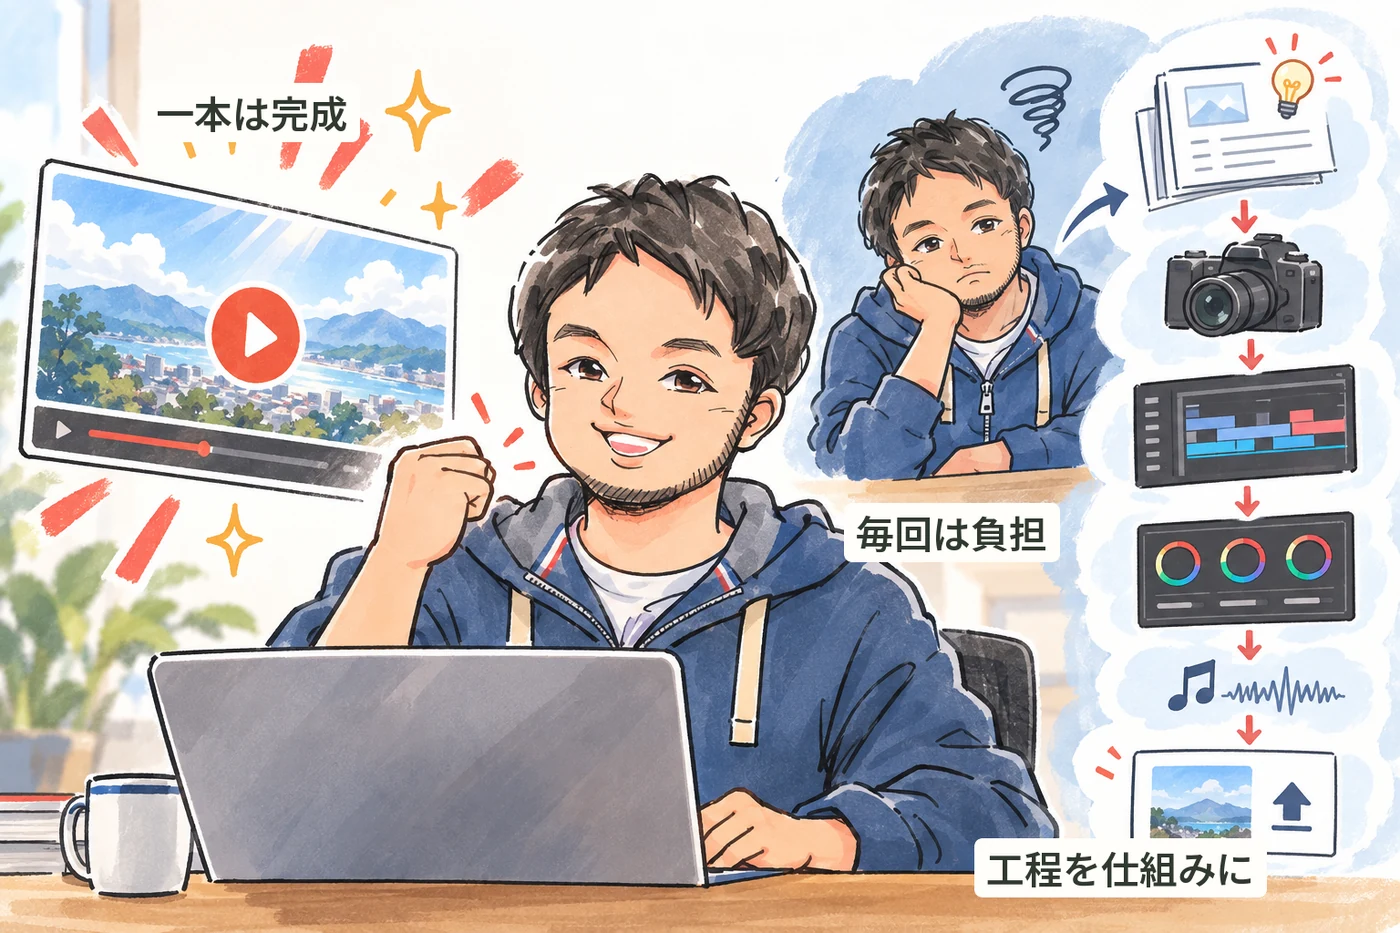
Japan Dining Cardのプロモーション動画を、AIを使って作った。
原稿を書き、文章でシーンを組み立て、絵コンテにし、ラフアニメを確認してから本番制作へ進む。以前考えていた制作フローを、今回は実際に回した。
CodexやRemotionに加え、ChatGPT、Adobe Firefly、Veo 3.1、ElevenLabs、Canvaなども使った。動画そのものは、概ね満足できる品質まで持っていけた。
ただ、一つ大きな問題が残った。
Codexの利用枠の消費が、かなり大きい。
一本作れることは分かった。でも、今後も毎回この作り方を続けるのかと考えると、仕組みを見直したくなった。
工程が決まってきたのに、毎回Codexに作業を頼んでいる
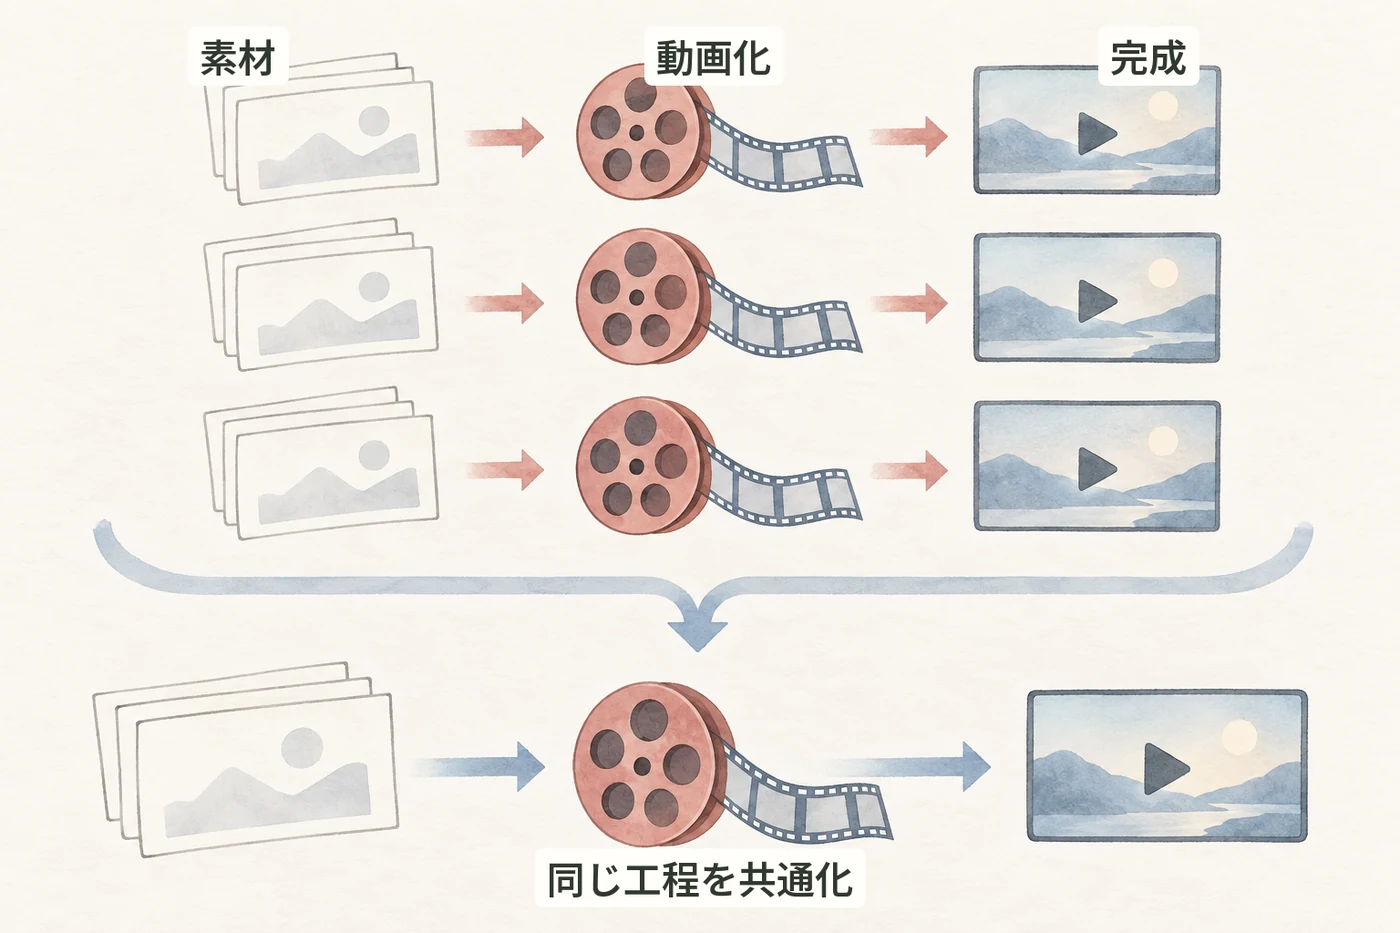
原稿を読み、シーンを分解し、素材を確認する。Remotionのコードを書き、画像や動画を配置する。確認して直し、またレンダリングする。
こうした作業をCodexに頼んでいると、制作のたびに利用量が積み上がっていく。
もちろん、その場で考えてほしいこともある。何を見せるか、どんな構図がよいか、修正するとしたらどこか。そこには判断が必要だ。
一方で、制作フローそのものは、すでにかなり固定化されてきている。シーンごとに素材を用意し、音声と字幕を合わせ、ラフを確認し、本番素材に置き換える。この流れは、次の動画にも使いたい。
それなら、繰り返す部分を仕組みとして残せないだろうか。Codexには、自分専用の動画制作システムを作ってもらう。普段の制作では、そのシステムを使う。新しい機能が必要になった時や、不具合を直す時に、またCodexの力を借りる。
今作っている「Video Factory」は、そういうものだ。現時点でパイロットは完成間近。過去に作った動画をインポートして、シーンを修正できるか試すところまで来ている。
実際に使えるかの検証はこれからだが、構想から、動かして確かめる段階へ進みつつある。
登場人物を作り直し、動画の巻き戻しにも出会った
制作中には、やり直しになった場面もある。
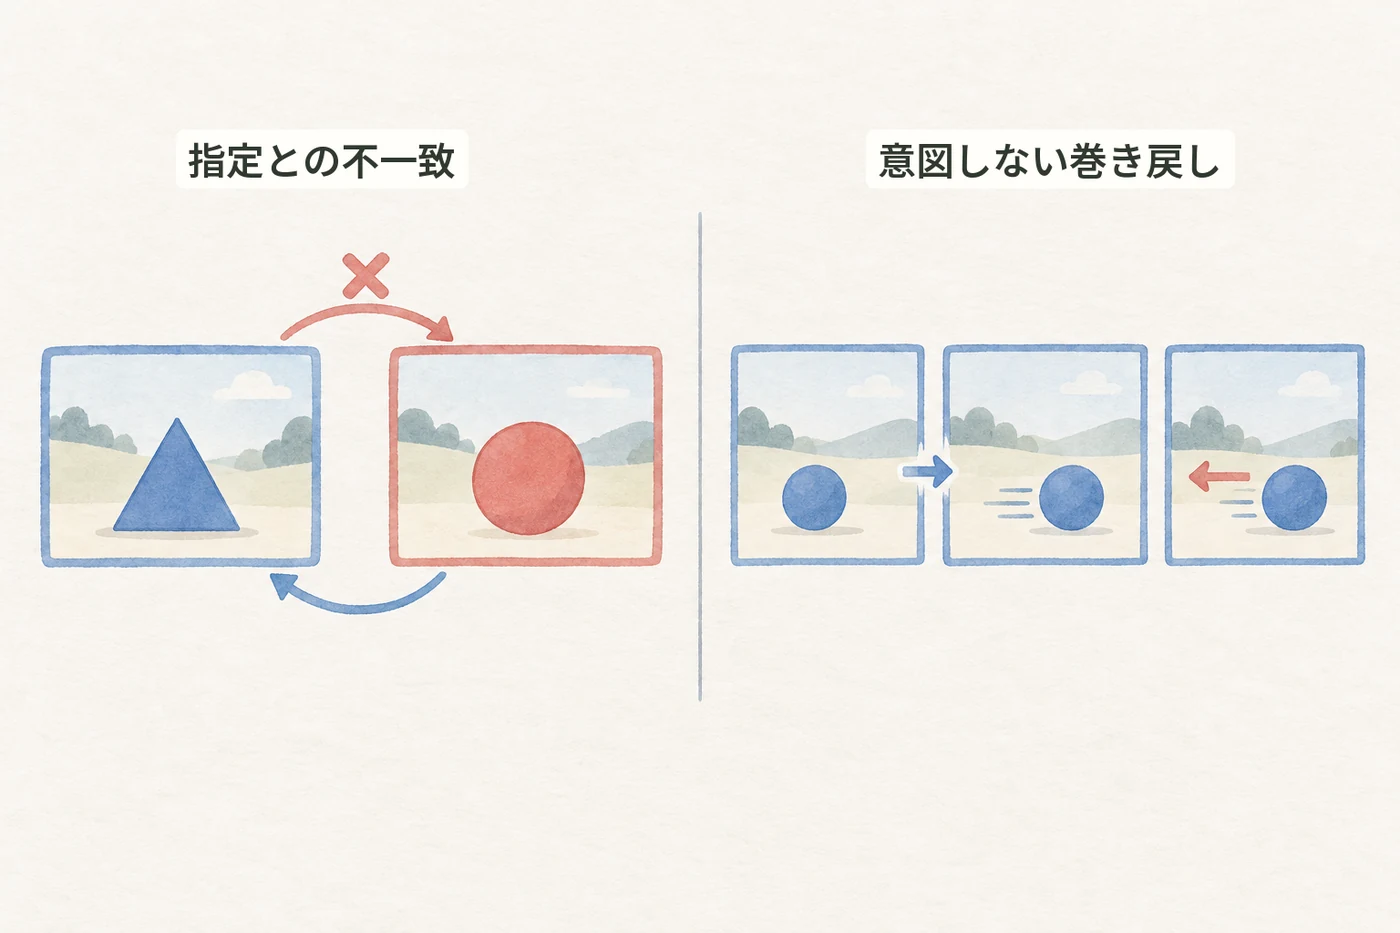
Codexに文章コンテを作らせ、その後、絵コンテ用の画像生成プロンプトも作らせた。ところが、その指定が甘く、できあがった登場人物が全員日本人になってしまった。自分が登場させたかったのは外国人で、そこから作り直すのに手間がかかった。
誰が出てくる場面なのかという大事な条件が、画像生成まで伝わっていなかった。文章コンテやプロンプトを用意するだけでなく、生成された絵を見て確かめる必要があった。
さらに、一部の動画AIでは、動画が逆再生されるように巻き戻ることも起きた。
人物が意図どおりかは絵を見て確認できるが、動きについては実際に再生してみないと分からない。やはりテストは重要だと感じた。
こうした経験も、Factoryに人間の確認を残したい理由になっている。プロンプトを用意して生成するだけでなく、出てきたものを見て、必要ならそのシーンを修正できるようにしたい。
手動で作る工程も、最初から入れておく
このFactoryで、すべての操作を自動化したいわけではない。
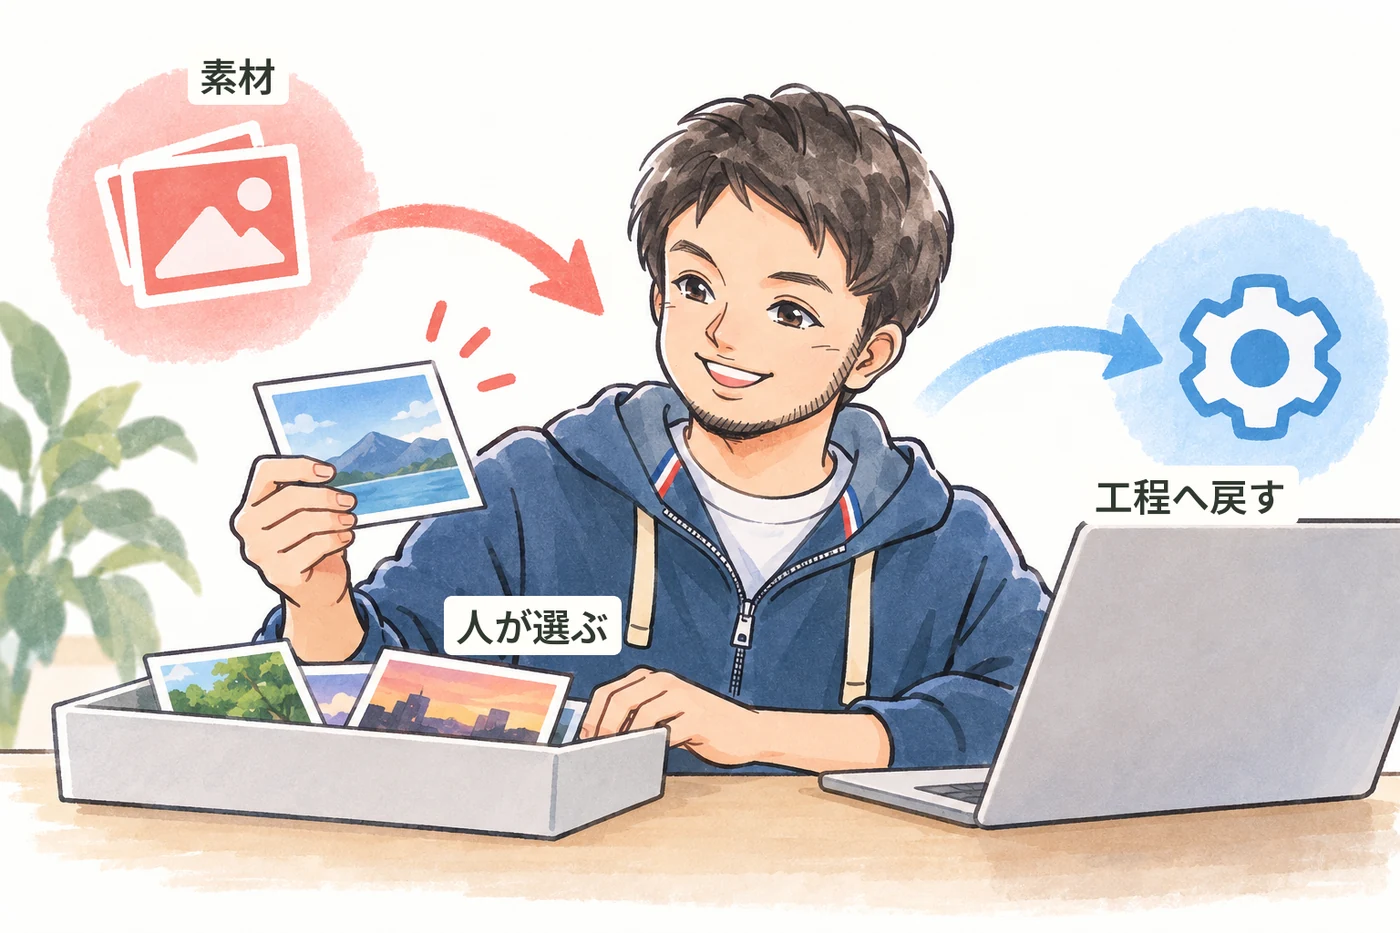
たとえば、重要な絵コンテやキャラクターの構図は、ChatGPTと対話しながら詰めたいことがある。FireflyやCanvaの画面で、自分が操作したい場面もある。できあがった素材を見て、使うかどうかは自分で決めたい。
そうした手作業を、最初から制作工程に含めておく。あるシーンを作る時、Factoryがプロンプト、縦横比、参照画像、必要な構図をまとめて提示する。僕が指定したサービスで素材を作り、できたものをFactoryへ戻す。その素材がどのシーンの何版なのか分かる状態で、次の工程へ進める。
これなら、自分で操作することと、制作全体を管理することを両立できそうだ。
目指しているのは、人間が途中で判断する半自動の制作環境。人が関わる場所も含めて、繰り返し使える形にしたい。
動画の設計を、コードの外にも持つ
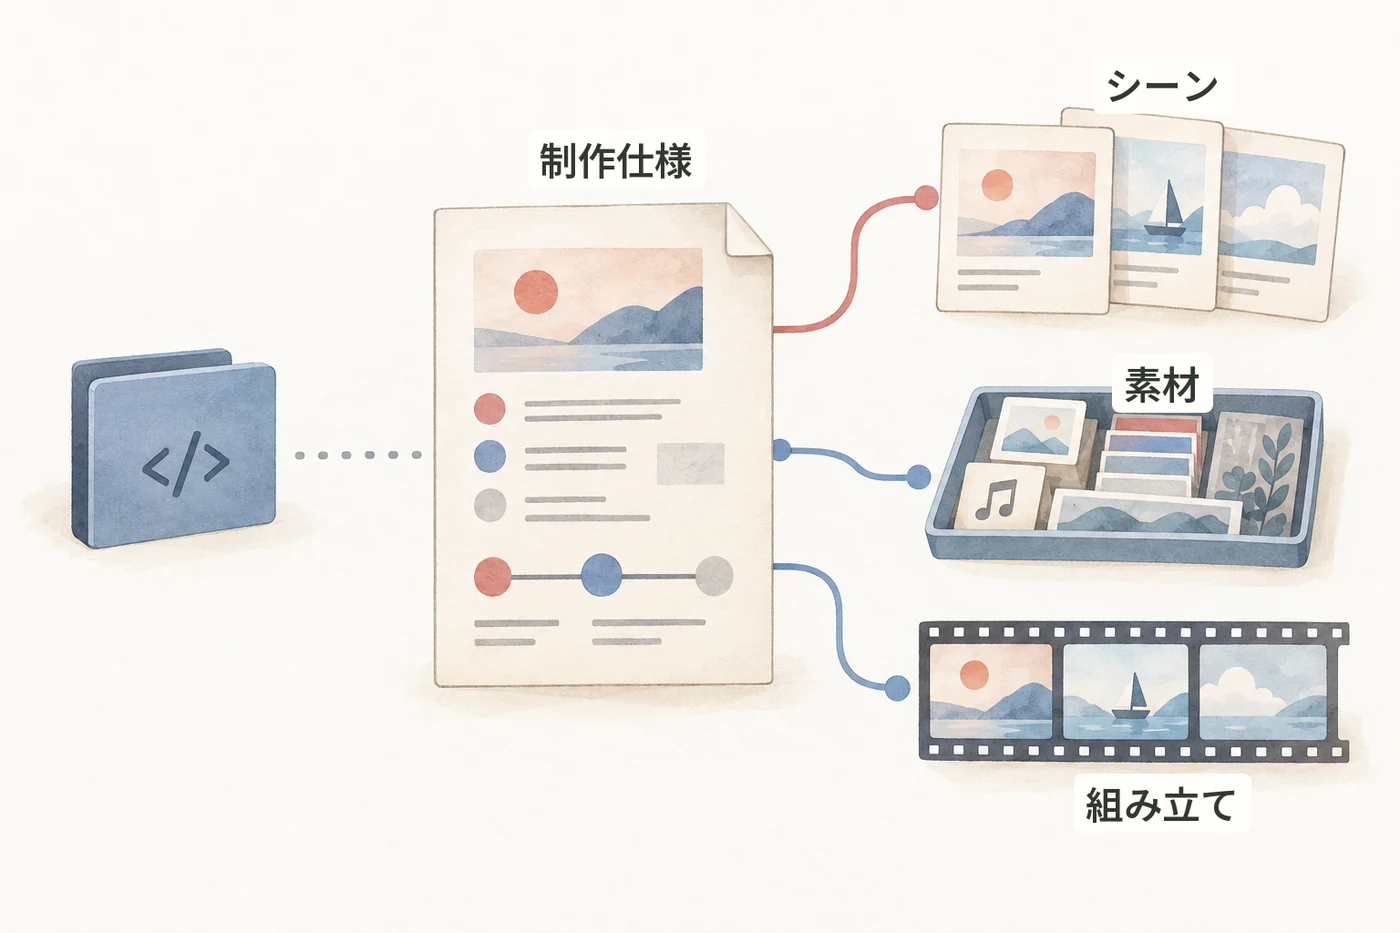
その中心に置こうとしているのが、production_spec.jsonという制作仕様ファイルだ。
名前は少し難しそうだが、各シーンの設計と進捗をまとめるものだと考えている。
何を伝える場面なのか。何秒使うのか。ナレーションと字幕は何か。どの素材を使い、どの方法で作るのか。人の確認は済んでいるのか。
こうした情報を、制作の基準になる一か所に持たせたい。
たとえば、まだ素材がないシーンなら、次に必要な作業を表示する。素材が戻ってきたらプレビューで確認する。採用する版を決めたら、その指定に沿って組み立てる。
Remotionには、画像、動画、音声、字幕などを指定どおりに配置する役割を持たせる。毎回ゼロからコードを書き直す範囲を減らし、共通部分を使い回せるようにしたい。
毎回AIに判断させなくてもよいことがある
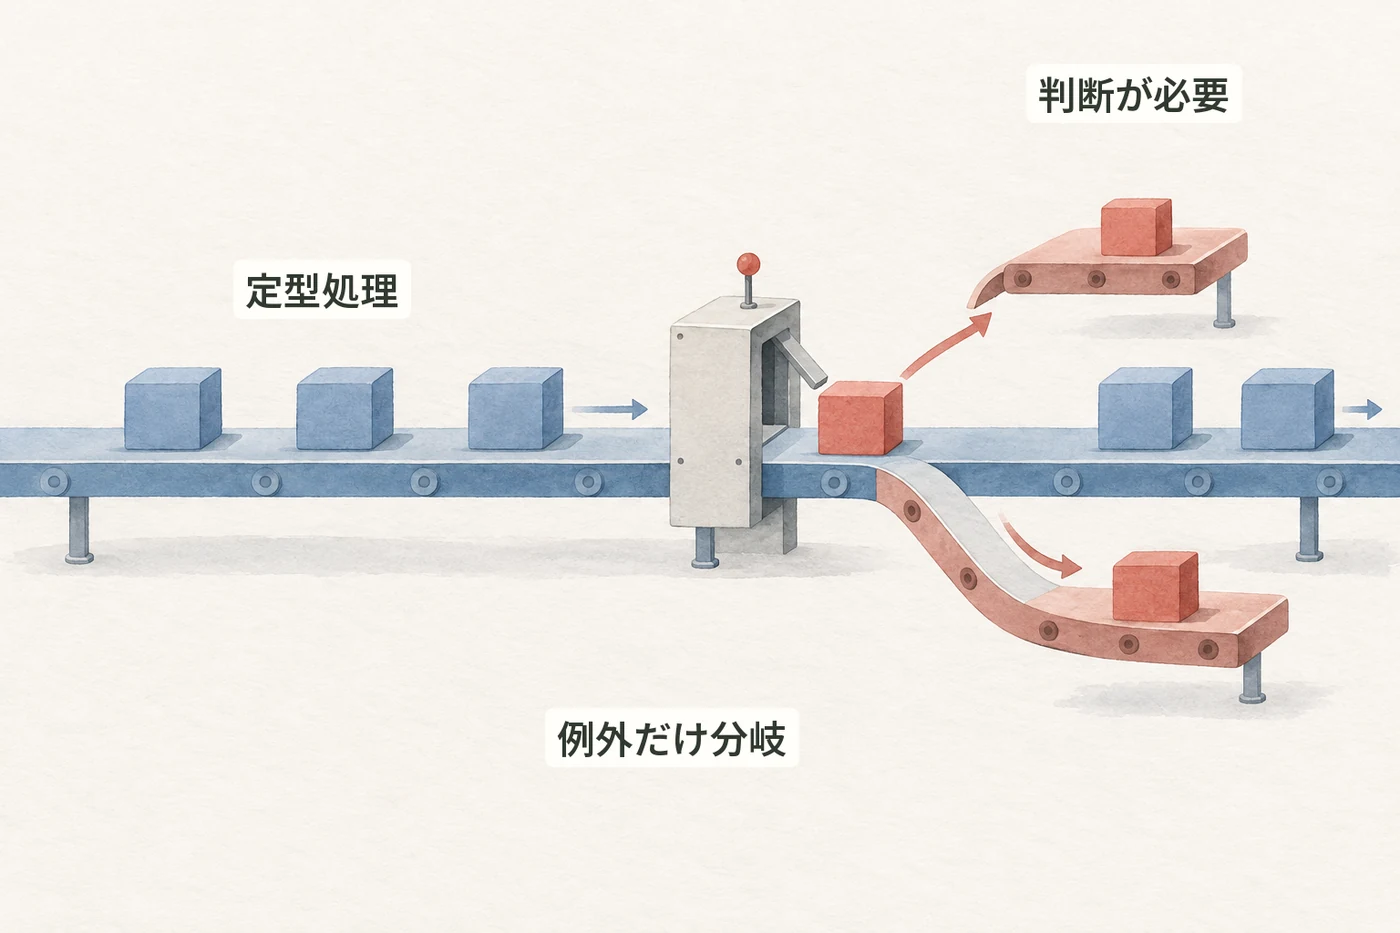
素材を作るサービスは、一つに固定しないつもりだ。
ただし、候補が増えるほど、選ぶ作業まで毎回発生する。それでは、別の手間が増えてしまう。
そこで、先に決められる条件はルールにしておきたい。
正確な文字が必要な場面は、文字を編集できるCanvaやRemotionで作る。実際のアプリ画面を見せる場面は、本物のスクリーンショットや画面録画を使う。日本語ナレーションは、今の自分の方針としてAivisを使う。
そのうえで、映像の雰囲気や表現方法など、迷うシーンだけAIに選択を手伝ってもらう。構想では、Jevにその判断を担ってもらうことも考えている。
迷うところにAIを使い、すでに決めたことは次の制作にも引き継ぐ。この分け方が、自分には必要なのだと思う。
本番素材を作り込む前に、ラフで見る
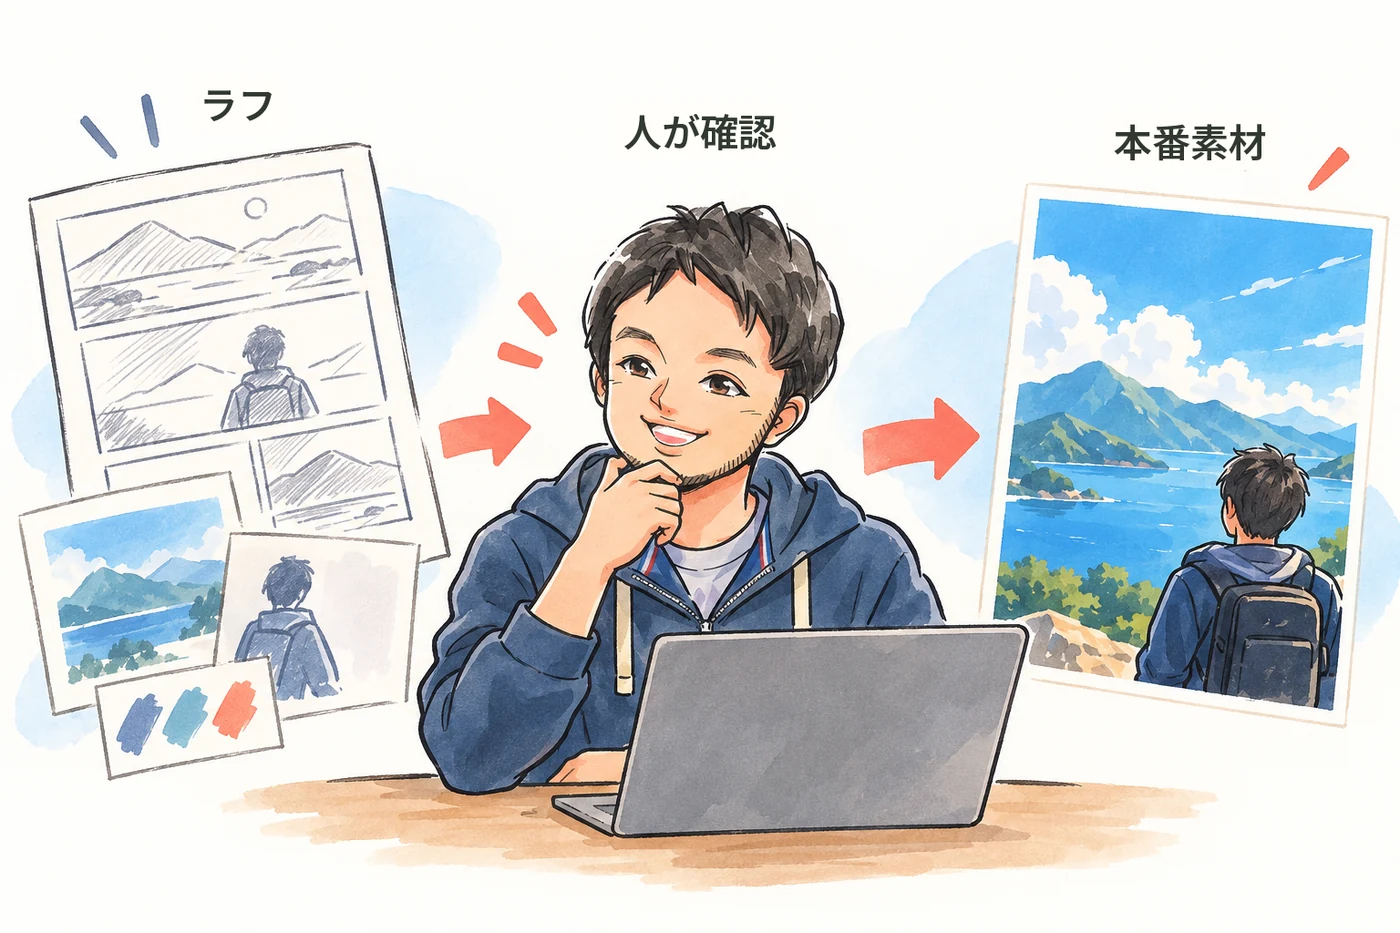
今回回した制作フローの中でも、ラフアニメを確認する工程は、今後の標準に残したい。
絵コンテの静止画に仮のナレーションと字幕を合わせ、簡単なズームや場面転換を付ける。その状態で、尺、テンポ、シーンの順番、意味の伝わり方を見る。
一枚ずつの絵がよくても、つなげた時に伝えたいことが伝わるかは別に確かめたい。そこで直したいところが見つかったら、本番素材を作り込む前に修正する。
この確認を、自分が行う正式な工程にするつもりだ。
ただし、ラフがよくても、本番の動画素材まで意図どおりに動くとは限らない。巻き戻しの経験を踏まえると、生成した本番素材も再生し、動きを確認する工程が必要だと思っている。
生成や編集ができるだけ速く進むことに加えて、どこで立ち止まるかも設計しておきたい。
スマホの画面には、本物のアプリを映したい
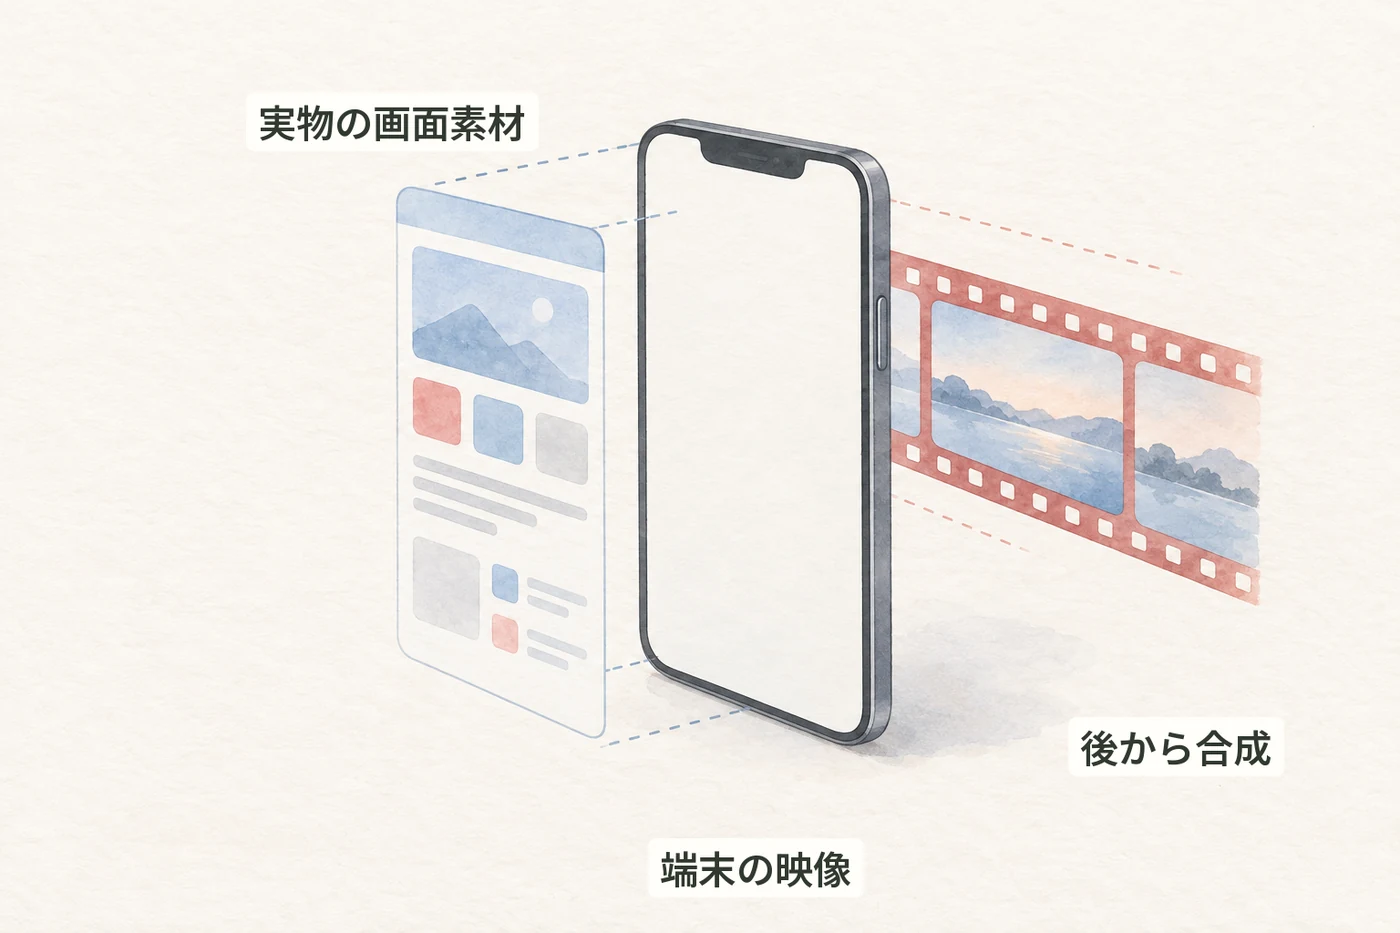
もう一つ、独立した工程にしたいのが、端末の画面を差し替える作業だ。
自分の動画では、人物がスマホやタブレット、PCを操作する場面をよく使う。そこで見せたいのは、自分が作ったアプリやゲームの画面だ。文字や配置まで含めて、実物を正確に見せたい。
そのため、人物や周囲の映像と、端末内に表示する画面を分けて考えている。
映像を生成する段階から、画面の角が見えやすく、指や強い反射で隠れすぎない構図を狙う。その後、本物のスクリーンショットや画面録画を合成する。After EffectsやMocha AEなどを使う方法も候補にしている。
ここも、まだ自動でうまく処理できると確認したわけではない。画面が動く、指が重なる、といった条件で作業量は変わるはずだ。
それでも、生成前から「後で本物の画面を入れる」と決めておくことは、Factoryの設計に含めたい。
まずは過去作品を取り込み、シーンを直せるか試す
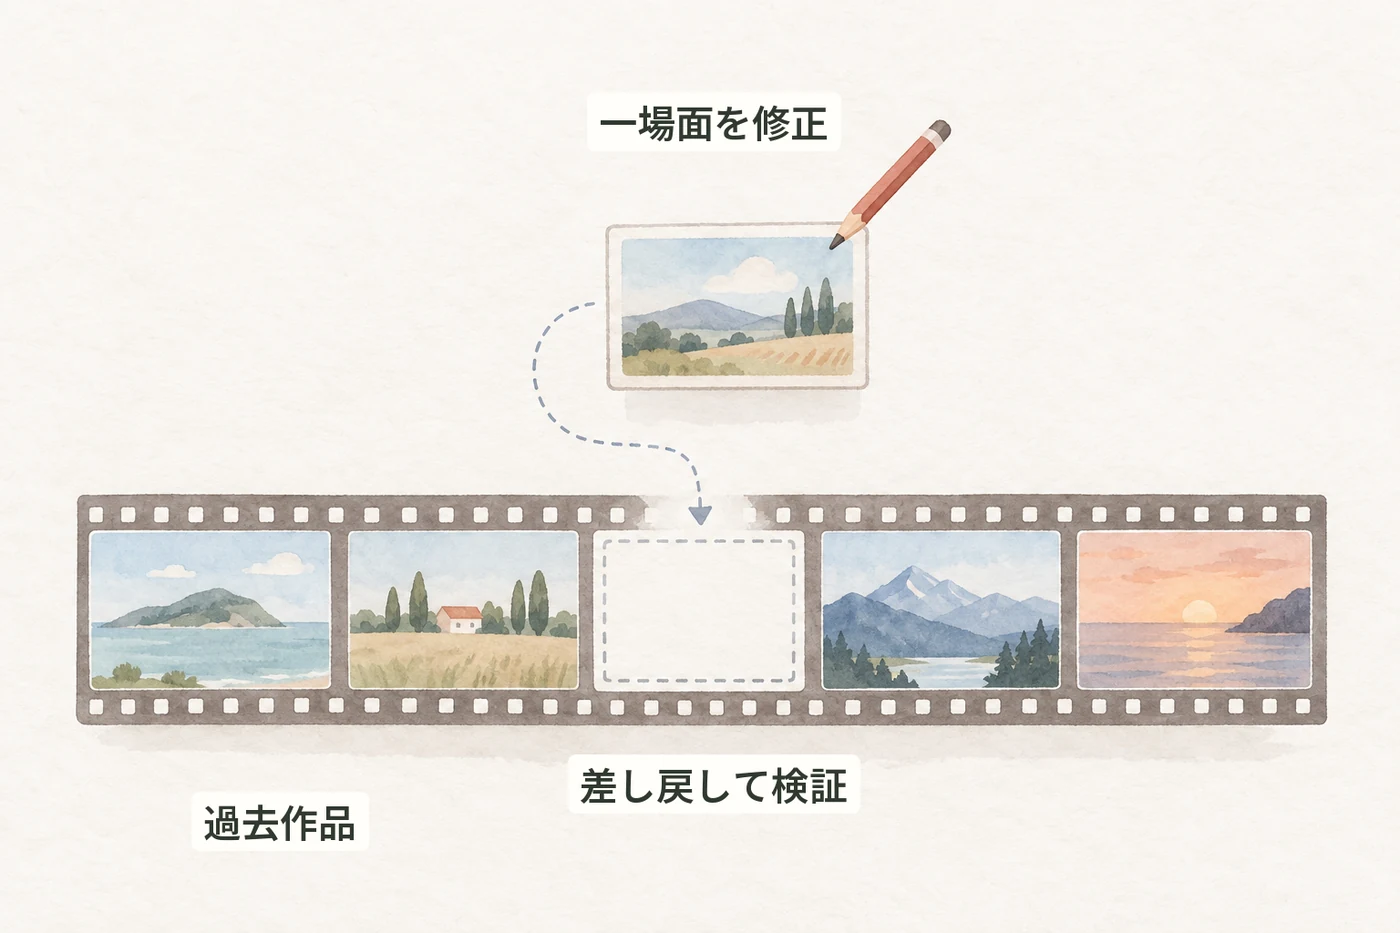
今のところ、Video Factoryによって利用枠をどれだけ節約できるか、制作時間がどれだけ短くなるかは分からない。仕組みを作るにも、保守するにも手間はかかる。
だから、機能をたくさん揃えたことだけで満足しないようにしたい。
直近で試すのは、過去作品のインポートとシーン修正だ。すでにある動画を取り込んで、直したい場面を修正できるか。まずはそこを確かめる。現時点では、この試験を通ったという結果はまだない。
今回分かったのは、自分が概ね満足できる動画を作れたことと、その作り方を毎回繰り返すには利用枠の消費が気になること。そして、繰り返し使いたい工程が具体的に見えてきたことだ。
次の一本では、どの工程をそのまま使い回せたか。どこでは自分の判断が必要だったか。Codexに追加で頼む作業はどれくらい残ったか。そこを確かめたい。
一本目を作る中で得た手順や判断を、二本目にも残す。自分専用のVideo Factoryは、そのために作っている。まずは完成間近のパイロットで、過去作品の一場面を直せるか試したい。